
في عصر الذكاء الاصطناعي المزدهر، حيث تتسابق الشركات لدمج النماذج اللغوية الكبيرة (LLMs) في عملياتها، يظهر نمط معماري مقلق: يتم وصف النصوص البرمجية الإجرائية البسيطة بأنها "وكلاء ذكاء اصطناعي". هذه الأنظمة، التي يطلق عليها البعض تهكماً "عبارات If-Statement باهظة الثمن"، تعتمد على LLMs لتنفيذ مهام لا تتطلب فهماً سياقياً حقيقياً أو استدلالاً ديناميكياً. غالباً ما تؤدي هذه المقاربة إلى تكاليف عالية لواجهة برمجة التطبيقات (API)، وتأخيرات غير حتمية، وفشل غير متوقع، ومع ذلك يتم تسويقها كحلول رائدة في مجال الأتمتة المستقلة.
يهدف هذا المقال إلى تبديد وهم الذكاء هذا. سنتجاوز الضجيج التسويقي لنتعمق في الواقع التقني: لماذا يُعد استخدام LLM لاتخاذ قرار بشأن واجهة برمجة تطبيقات معينة بناءً على منطق ثابت، فشلاً في التصميم. بدلاً من ذلك، سنستكشف الانتقال من معماريات "LLM-First" إلى معماريات "Workflow-First" مع تحسينات LLM، مما يؤدي إلى أتمتة قوية، قابلة للاختبار، وفعالة من حيث التكلفة.
وهم الذكاء: لماذا وكيل الذكاء الاصطناعي الخاص بك مجرد نص برمجي مطوّل؟
لفهم سبب كون معظم "وكلاء" الذكاء الاصطناعي مجرد نصوص برمجية، يجب أن ننظر إلى تدفق التحكم. في الوكيل المستقل الحقيقي، يمتلك النموذج اللغوي الكبير (LLM) حلقة (عادةً ما تكون بنية ReAct أو Plan-and-Execute) حيث يراقب الحالة، يفكر، يتصرف، ويراقب النتيجة، مع تحديد النموذج اللغوي الكبير للخطوة التالية ديناميكياً. أما في نمط "If-Statement باهظ الثمن" المعيب، فإن تدفق التحكم يكون ثابتاً، ولكن يتم الاستعانة بـ LLM لاتخاذ القرار دون تزويده بالأدوات اللازمة للتنقل في التعقيد.
لنأخذ نظام تذاكر دعم العملاء كمثال. قد يبدو التنفيذ الهش كالتالي:
- يتلقى LLM تذكرة.
- يقول التوجيه (Prompt): "إذا سأل المستخدم عن استرداد الأموال، استدعِ
refunds_api. إذا سأل عن إعادة تعيين كلمة المرور، استدعِauth_api." - يُخرج LLM كائن JSON يحدد الدالة التي يجب استدعاؤها.
- يقوم النظام بتنفيذ الدالة.
تقنياً، هذا مجرد عبارة switch/case حيث المترجم هو LLM. يضيف LLM قيمة فقط في تحليل اللغة الطبيعية، لكن المنطق يكون مبرمجاً بشكل ثابت في التوجيه. إذا قال المستخدم، "لقد اشتريت هذا الثلاثاء الماضي، وهو معطل، وأريد استعادة أموالي،" فقد يقوم LLM بالهلوسة بأنه يحتاج إلى استدعاء "return_api" غير موجودة، أو قد يواجه صعوبة في ربط المشاعر بالقيود المحددة لـ refunds_api.
الـ "ذكاء" هنا وهمي لأن النظام لا يمكنه التعافي من أخطائه الخاصة. لا توجد حلقة تغذية راجعة لكي يصحح LLM مساره. إنها مهمة تنبؤية أحادية اللقطة متنكرة في هيئة وكيل.
نصيحة للمطورين / Dev Tip: تجنب استخدام النماذج اللغوية الكبيرة (LLMs) كـ "مترجمات" للمنطق الثابت. بدلاً من ذلك، ركز على استخدامها في المهام التي تتطلب فهماً سياقياً حقيقياً للغة الطبيعية، ودع المنطق الحاسم يُدار بواسطة كود برمجي تقليدي.
أنماط الفشل التقني لوكلاء الذكاء الاصطناعي الهشين
عندما تقوم بنشر هذه "If-Statements باهظة الثمن" في بيئة الإنتاج، تظهر ثلاثة أنماط فشل محددة باستمرار:
اختيار الأداة غير الحتمي (Non-Deterministic Tool Selection)
النماذج اللغوية الكبيرة احتمالية بطبيعتها. حتى مع temperature=0، لا تضمن مخرجات متطابقة للمدخلات المتطابقة عبر إصدارات نموذج مختلفة أو حتى عمليات استنتاج مختلفة. إذا قرر LLM أن "حالة الطلب" تتطلب أداة get_order، فقد يقرر أحياناً أن get_logistics أكثر ملاءمة. بدون حواجز حتمية، يتصرف النظام بشكل غير منتظم.
تضخم نافذة السياق والتكلفة (Context Window Bloat and Cost)
غالباً ما تحشو هذه الوكلاء الهشة كميات هائلة من الوثائق في توجيه النظام لضمان معرفة LLM بالأدوات الصالحة. يؤدي هذا إلى دفع آلاف الرموز المميزة في كل طلب لتذكير النموذج بأن tool_A موجودة. في نظام عالي الحجم، يجعل هذا الحمل الزائد لـ LLM محرك التكلفة المهيمن، مما يلغي أي مكاسب في الكفاءة من الأتمتة. يمكن للمطورين استكشاف وكلاء الذكاء الاصطناعي: أسرار التكلفة والتصميم الأمثل لفهم أعمق لتأثير التكلفة.
نقص إدارة الحالة (Lack of State Management)
يتطلب الوكلاء الحقيقيون ذاكرة. عادةً ما تتعامل عبارات If-Statement الهشة مع كل تفاعل على أنه بلا حالة. إذا تطلبت مهمة عملية متعددة الخطوات (مثل، التحقق من هوية المستخدم، التحقق من سجل الطلبات، معالجة استرداد الأموال)، غالباً ما يفشل الوكيل الهش في الحفاظ على سير العمل. قد يحاول استرداد الأموال قبل التحقق من الهوية، أو يدخل في حلقة لا نهائية لأنه لا يتتبع الخطوات المكتملة بالفعل.
نصيحة للمطورين / Dev Tip: صمم اختبارات وحدة قوية لأدواتك ووظائفك بدلاً من الاعتماد على LLM لاتخاذ قرارات حاسمة. يجب أن تكون الأدوات قابلة للتوقع ومستقلة قدر الإمكان.
التحول المعماري: من الاستقلالية إلى الأوركسترا
الحل ليس في إزالة LLM، بل في إزالة سلطته على تدفق التحكم. يجب أن ننتقل من الوكلاء المستقلين (Autonomous Agents) إلى سير العمل المنسق (Orchestrated Workflows).
في هذا النموذج، يكون LLM مكوناً متخصصاً، وليس عقل النظام. يتعامل مع تفسير البيانات غير المهيكلة (NLP) وتوليد المحتوى، بينما يتعامل محرك حتمي (منظم سير العمل) مع المنطق، التسلسل، ومعالجة الأخطاء.
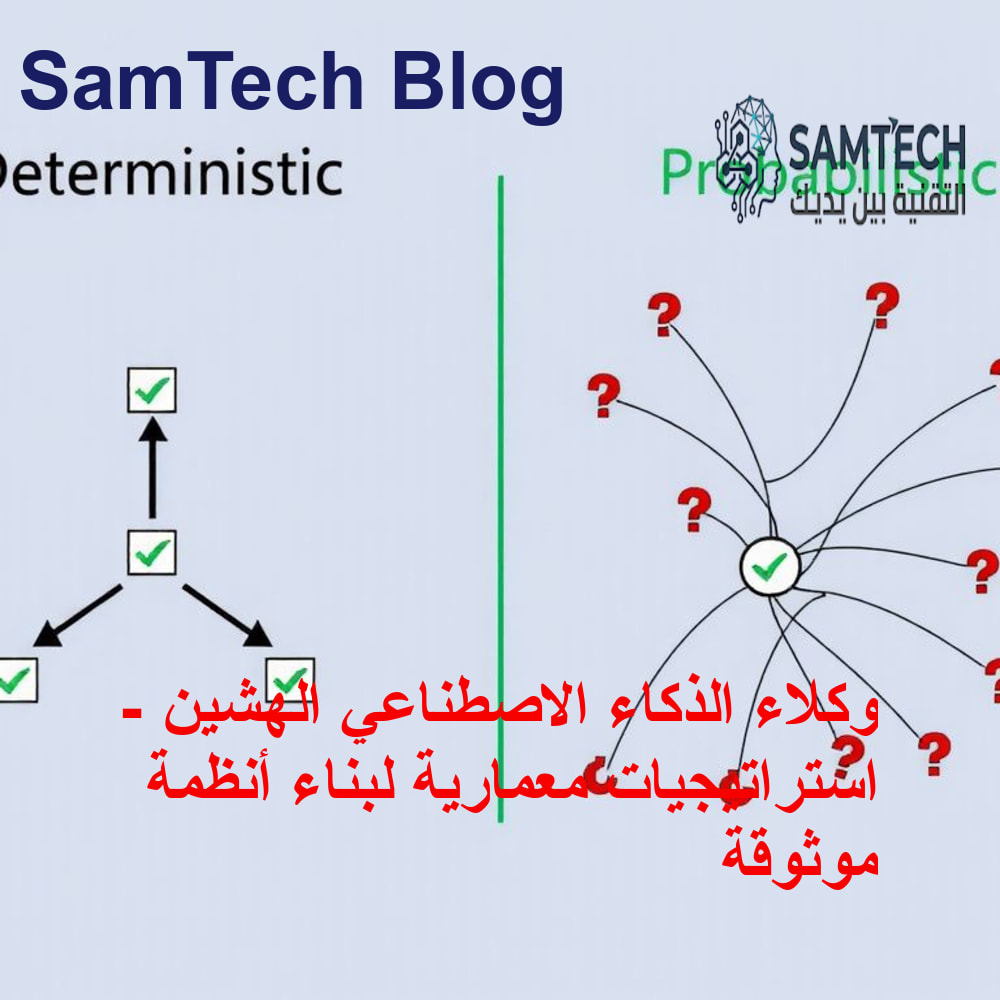
يتوافق هذا مع إدراك الصناعة بأن LLMs هي في الأساس آلات حالة احتمالية، وليست بوابات منطقية. معاملتها على هذا النحو - إجبارها على إدارة تدفق التحكم، أو الحفاظ على حالة طويلة الأجل، أو ضمان مخرجات دقيقة - هو السبب الجذري لمعظم الهشاشة المعمارية في أنظمة الذكاء الاصطناعي المنتجة.
الحد الحتمي-الاحتمالي (The Deterministic-Probabilistic Boundary)
نمط الفشل الأكثر شيوعاً الذي نلاحظه هو "تسرب المنطق". يحدث هذا عندما يقوم المطورون بتضمين قواعد عمل معقدة (شروط if/else، انتقالات الحالة، التحقق من صحة البيانات) مباشرة في توجيه LLM. نظراً لأن LLMs غير حتمية، تصبح هذه القواعد مجرد اقتراحات بدلاً من ضمانات.
نمط مضاد: "توجيه الإله" (The "God Prompt")
# خطر: تضمين منطق معقد في التوجيه (Prompt)
response = llm.generate(
    f"""
    أنت وكيل دعم عملاء.
    1. إذا كان المستخدم غاضباً، اعتذر فوراً.
    2. إذا كانت المشكلة تتعلق بالفوترة، تحقق من قاعدة البيانات لآخر 3 فواتير.
    3. إذا كان الإجمالي > 100 دولار، اقترح استرداد الأموال.
    4. إذا كان الإجمالي <= 100 دولار، اقترح قسيمة خصم.
    """
)
هذا النمط خطير لأنه يعهد بالمنطق الحاسم إلى LLM. الطريقة الصحيحة هي فصل المنطق عن التفسير:
# الأفضل: فصل المنطق عن LLM
# 1. LLM لاستخراج النية والمشاعر
intent_data = llm.classify_intent_and_sentiment(user_input)

# 2. كود حتمي لإدارة المنطق
if intent_data.sentiment == "angry":
    apology = llm.generate_apology()
    send_message(apology)

if intent_data.intent == "billing":
    invoices = db.get_invoices(user_id)
    total_amount = sum(invoice.amount for invoice in invoices)
    if total_amount > 100:
        llm_suggestion = llm.generate_refund_suggestion()
        send_message(llm_suggestion)
    else:
        llm_suggestion = llm.generate_coupon_suggestion()
        send_message(llm_suggestion)
في هذا النموذج، يتم تطبيق قاعدة "الإجمالي > 100 دولار" بدقة 100%، بينما يوفر LLM الفروق الدقيقة الشبيهة بالبشر في الاعتذار والتفسير.
ملاحظة هندسية: استخدم LLMs لتوليد المحتوى وتفسير اللغة الطبيعية، ولكن حافظ على المنطق الأساسي وتدفق التحكم في كود برمجي حتمي. هذا يضمن قابلية التوقع والموثوقية لنظامك.
تشخيص الهشاشة: محاور الفشل الثلاثة
لتشخيص وكيل، يجب أن نعزل نقاط الفشل. نصنف الفشل إلى ثلاثة محاور: هشاشة السياق (Context Fragility)، انحراف الحالة (State Drift)، وغموض الأداة (Tool Ambiguity).
هشاشة السياق (مشكلة "الضياع في المنتصف")
لدى النماذج اللغوية الكبيرة مدى انتباه محدود. مع نمو سجل المحادثة، تتدهور قدرة النموذج على تذكر القيود المبكرة. هذه ليست مجرد مشكلة حد الرموز المميزة؛ إنها مشكلة بروز. يعطي النموذج الأولوية للرموز المميزة الحديثة على تعليمات النظام المبكرة.
اختبار تشخيصي: أدخل قيداً محدداً في بداية محادثة من 50 دورة. اطلب من النموذج تذكره في الدورة 51. إذا فشل، فإن بنيتك تفتقر إلى الذاكرة المحسنة بـ RAG أو ضغط الملخص.
الحل: نفذ استراتيجية "نافذة منزلقة مع تلخيص" (Sliding Window with Summarization).
- احتفظ بآخر $N$ رسالة حرفياً.
- اضغط الرسائل الأقدم من $N$ في ملخص باستخدام LLM رخيص وسريع.
- ادمج الملخص في توجيه النظام جنباً إلى جنب مع استعلام المستخدم الحالي.
انحراف الحالة (مشكلة "المتغير الزومبي")
في الوكلاء متعددي الخطوات، غالباً ما تكون المتغيرات المعرفة في الخطوة 1 غير معرفة في الخطوة 4. "ينسى" LLM أنه استخرج سابقاً user_email أو يهلوّس ببريد إلكتروني جديد. يمكن التعمق في هذه التحديات في مقال تأمين وحوكمة الذكاء الاصطناعي: دليل المطور الشامل.
اختبار تشخيصي: تتبع تدفق البيانات بين استدعاءات الأدوات. إذا كان استدعاء أداة في الخطوة 3 يستخدم متغيراً لم يتم تمريره صراحة من مخرجات الخطوة 2، فلديك انحراف في الحالة.
الحل: استخدم إدارة الحالة الصريحة (Explicit State Management). يجب أن يحتفظ المنسق بكائن State. يجب أن يتلقى كل استدعاء LLM الحالة الحالية كمدخل، ويجب تحليل مخرجات LLM لتحديث الحالة. لا ينبغي أبداً الثقة بـ LLM في تذكر قيم المتغيرات من الأدوار السابقة دون إعادة حقن صريحة.
class AgentState:
    user_email: Optional[str] = None
    order_id: Optional[str] = None
    current_step: str = "start"
غموض الأداة (لعبة "التخمين")
إذا كان وصف الأداة غامضاً، فسوف يخمن LLM. "جلب البيانات" غامض. "جلب ملف تعريف المستخدم بما في ذلك البريد الإلكتروني والعنوان، بتنسيق JSON، للمستخدم المرتبط بالجلسة الحالية" دقيق.
اختبار تشخيصي: اخلط ترتيب تعريفات أدواتك. إذا تغير سلوك الوكيل أو فشل في تحديد الأداة الصحيحة، فإن أوصاف أدواتك ليست مميزة بما يكفي.
الحل: اعتمد مخططات الأدوات ذات القيود السلبية (Tool Schemas with Negative Constraints). بدلاً من مجرد قول ما تفعله الأداة، قل ما لا تستطيع فعله.
- سيء:
get_invoice(id) - جيد:
get_invoice(order_id: str) -> Invoice. يسترد الفاتورة النهائية المدفوعة فقط. لا تستخدم للطلبات المعلقة. يتطلب UUID صالحاً لـ order_id.
نصيحة للمطورين / Dev Tip: قم بتوثيق أدواتك بدقة ووضوح، مع تحديد المدخلات والمخرجات والقيود بوضوح. عامل أوصاف الأدوات كعقود برمجية لضمان استخدام LLM لها بشكل صحيح.
التنفيذ: بناء إطار عمل وكيل مرن
فيما يلي هيكل أساسي جاهز للإنتاج لوكيل يفصل الاهتمامات. يستخدم هذا المثال Python، Pydantic للتحقق الصارم من المخطط، وعميل LLM عام.
آلة الحالة (The State Machine)
from pydantic import BaseModel, Field
from enum import Enum
from typing import Optional, List
import json

class Step(Enum):
    START = "start"
    EXTRACT_EMAIL = "extract_email"
    VERIFY_ORDER = "verify_order"
    GENERATE_REPLY = "generate_reply"
    END = "end"

class AgentState(BaseModel):
    current_step: Step = Step.START
    user_input: str = ""
    email: Optional[str] = None
    order_id: Optional[str] = None
    order_exists: bool = False
    final_response: Optional[str] = None

    def history(self) -> List[str]:
        return [self.user_input, f"Email found: {self.email}", f"Order {self.order_id} exists: {self.order_exists}"]
عميل LLM (طبقة التجريد) (The LLM Client - Abstraction Layer)
نقوم بتجريد LLM للسماح بالتبديل السهل ولفرض وضع JSON حيثما أمكن.
import os
from openai import OpenAI

class LLMClient:
    def __init__(self):
        self.client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
        self.model = "gpt-4o"

    def classify(self, prompt: str, schema: dict) -> dict:
        """
        Forces the LLM to output structured data matching a JSON schema.
        """
        response = self.client.chat.completions.create(
            model=self.model,
            response_format={"type": "json_object"},
            messages=[
                {"role": "system", "content": "You are a precise data extractor. Output ONLY valid JSON."},
                {"role": "user", "content": prompt}
            ]
        )
        return json.loads(response.choices[0].message.content)
المنسق (The Orchestrator)
هذا هو عقل النظام. يقوم بتشغيل آلة الحالة، ويستدعي LLM فقط عند الحاجة إلى التفسير.
class SupportAgent:
    def __init__(self):
        self.llm = LLMClient()
        self.state = AgentState()

    async def run(self, user_input: str):
        self.state = AgentState(user_input=user_input)

        # Loop until termination
        while self.state.current_step != Step.END:
            self.state.current_step = await self._dispatch()

        return self.state.final_response

    async def _dispatch(self) -> Step:
        match self.state.current_step:
            case Step.START:
                return await self._extract_email()
            case Step.EXTRACT_EMAIL:
                if self.state.email:
                    return Step.VERIFY_ORDER
                else:
                    return self._error_flow("Email not found")
            case Step.VERIFY_ORDER:
                return await self._verify_order()
            case Step.GENERATE_REPLY:
                return await self._generate_reply()
            case _:
                return Step.END

    async def _extract_email(self) -> Step:
        prompt = f"""
        Extract the user's email address from the following text.
        If no email is present, return null.
        Text: "{self.state.user_input}"
        JSON Schema: {{"email": "string|null"}}
        """
        result = self.llm.classify(prompt, {{"type": "object", "properties": {{"email": {{"type": "string"}}}}}})
        self.state.email = result.get("email")
        return Step.EXTRACT_EMAIL

    async def _verify_order(self) -> Step:
        # DETERMINISTIC LOGIC: No LLM involved
        # In a real app, this would call a database or API
        # Mocking: Assume order "ORD-123" exists
        self.state.order_id = "ORD-123" # In real life, extracted from context or user
        self.state.order_exists = await self._mock_db_check(self.state.order_id)
        return Step.VERIFY_ORDER if self.state.order_exists else Step.ERROR

    async def _generate_reply(self) -> Step:
        # LLM generates human-like text based on deterministic facts
        prompt = f"""
        Draft a support response.
        Facts:
        - User email: {self.state.email}
        - Order ID: {self.state.order_id}
        - Order Status: {self.state.order_exists}

        Tone: Empathetic and professional.
        """
        response = self.llm.classify(prompt, {{"type": "object", "properties": {{"response": {{"type": "string"}}}}}}).get("response") # Using classify for structured output
        self.state.final_response = response
        return Step.END

    async def _mock_db_check(self, order_id: str) -> bool:
        return True # Placeholder

    async def _error_flow(self, reason: str) -> Step:
        self.state.final_response = f"Error: {reason}. Please provide valid information."
        return Step.END
ملاحظة هندسية: عند بناء وكلاء الذكاء الاصطناعي، استخدم نمط "Orchestrator" لفصل المنطق الحتمي عن التفسير الاحتمالي لـ LLM. هذا يزيد من قابلية الصيانة ويقلل من الأخطاء غير المتوقعة.
الاختبار والتقييم: تجاوز "الشعور الجيد"
لا يمكنك نشر وكيل بناءً على "يبدو أنه عمل ثلاث مرات". أنت بحاجة إلى أدوات التقييم (Eval Harnesses).
اختبار وحدة توجيهات LLM (Unit Testing the LLM Prompts)
عامل التوجيهات كاختبارات وحدة.
- مدخلات ثابتة: حدد مجموعة بيانات من 50 استعلاماً للمستخدم (حالات حافة، أخطاء إملائية، نوايا متعددة).
- مخرجات ذهبية: حدد تصنيف JSON المتوقع لكل منها.
- التحقق: قم بتشغيل الوكيل. تحقق مما إذا كان
state.emailيطابق القيمة الذهبية. تحقق مما إذا كانstate.order_idصالحاً.
اختبار المسار (Trajectory Testing)
بدلاً من مجرد اختبار المخرجات النهائية، اختبر المسار (Trajectory).
- هل استدعى الوكيل قاعدة البيانات قبل توليد الاستجابة؟
- هل قام الوكيل بالدوران أكثر من 5 مرات؟ (يشير إلى عدم الاستقرار)
- هل استخدم الوكيل الأداة الصحيحة؟
def test_trajectory_billing():
    input_msg = "I want to refund order 123, I'm really angry"
    state, logs = run_agent_with_logging(input_msg)

    assert state.final_response is not None
    # Assert that 'get_invoice' was called before 'generate_response'
    assert logs.tool_calls[0].name == "get_invoice"
    assert logs.tool_calls[1].name == "generate_response"
نصيحة للمطورين / Dev Tip: استثمر في أدوات التقييم الآلية (Eval Harnesses) واختبار المسار (Trajectory Testing) لضمان موثوقية وكلاء الذكاء الاصطناعي الخاصين بك. لا تعتمد على الاختبار اليدوي أو التخمين.
استراتيجيات إعادة الهيكلة الشائعة
من التسلسل إلى التوجيه (From Chaining to Routing)
إذا كان وكيلك عبارة عن سلسلة خطية (A -> B -> C)، اسأل عما إذا كان يجب أن يكون موجهاً (router).
- سلسلة: "استخراج البريد الإلكتروني -> التحقق من قاعدة البيانات -> الرد."
- موجه: "إذا كانت النية 'فوترة'، انتقل إلى BillHandler. إذا كانت 'شحن'، انتقل إلى ShipHandler."
التوجيه أكثر قابلية للتوسع. يسمح بالتنفيذ المتوازي للمعالجات المستقلة ويعزل الأخطاء.
إضافة بوابات "التدخل البشري" (Adding "Human-in-the-Loop" Gates)
بالنسبة للإجراءات عالية المخاطر (إرسال استرداد الأموال، حذف البيانات)، أدخل بوابة حتمية تتطلب موافقة بشرية أو خطوة تحقق ثانوية.
if self.state.amount > 1000:
    self.state.current_step = Step.HUMAN_REVIEW
    return
تخزين المخرجات الاحتمالية مؤقتاً (Caching Probabilistic Outputs)
استدعاءات LLM باهظة الثمن. قم بتخزين نتائج التصنيف/الاستخراج مؤقتاً بناءً على تجزئة الإدخال.
@lru_cache(maxsize=1000)
def classify(intent_text: str) -> Intent:
    ...
هذا يقلل من وقت الاستجابة والتكلفة للاستعلامات الشائعة دون التضحية بالجودة.
ملاحظة هندسية: استخدم التوجيه (Routing) بدلاً من التسلسل الخطي في تدفق عمل وكلاء الذكاء الاصطناعي لزيادة المرونة وقابلية التوسع. لا تتردد في دمج التدخل البشري للعمليات الحساسة.
الخاتمة: الطريق إلى النضج
إن وهم الذكاء يتلاشى في اللحظة التي نقبل فيها أن النماذج اللغوية الكبيرة (LLMs) هي مكونات، وليست أنظمة كاملة. إنها مستشعرات ومولدات قوية، ولكنها احتمالية بطبيعتها وليست حتمية. إنها ليست مشغلات للعمليات، بل أدوات مساعدة.
تُبنى بنية وكيل الذكاء الاصطناعي الناضجة على ثلاث ركائز أساسية:
- تدفق التحكم الحتمي: الكود البرمجي هو من يملك المنطق.
- التفسير الاحتمالي: النماذج اللغوية الكبيرة هي من تملك الفهم.
- إدارة الحالة الصريحة: تتدفق البيانات عبر عقود محددة، وليس عبر نوافذ سياق عشوائية.
من خلال إعادة هيكلة وكلاء الذكاء الاصطناعي الخاصين بك لاتباع هذا الفصل في الاهتمامات، فإنك تنتقل من أنظمة هشة يصعب تصحيحها إلى هندسة برمجية قوية وقابلة للاختبار. الهدف ليس جعل LLM "أكثر ذكاءً"؛ الهدف هو جعل النظام أكثر قابلية للتنبؤ.
إن الحدود التالية ليست نماذج أكبر، بل هي ربط أكثر إحكاماً بين الأنظمة الحتمية والعقول الاحتمالية. ابنِ المحرك. دع العقل يقود. نأمل أن يكون هذا المقال قد ألقى الضوء على كيفية بناء وكلاء ذكاء اصطناعي أكثر قوة وموثوقية. شاركونا أفكاركم وتجاربكم في التعليقات أدناه!